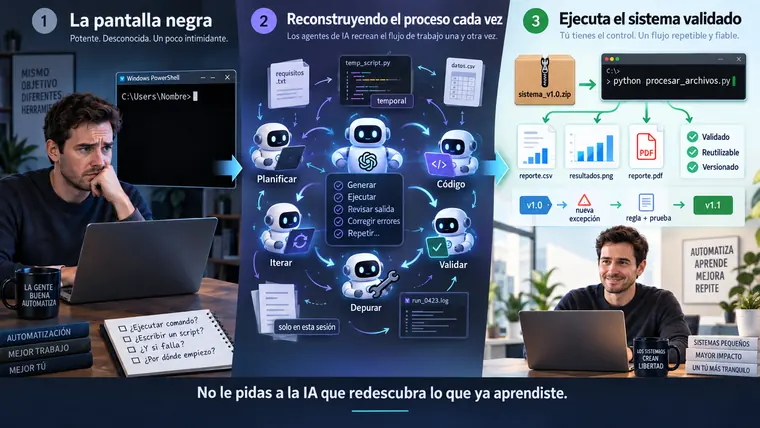
Hay una escena familiar para personas que trabajan todos los días con una computadora, dominan procesos complejos y, sin embargo, nunca han tenido necesidad de programar. El problema no es que la tarea sea difícil; es que una interfaz casi vacía puede parecer la entrada a un territorio que no les pertenece. En Windows aparece al abrir Command Prompt o PowerShell; en macOS o Linux, al abrir una Terminal. El resultado ya puede llegar por chat; esa comodidad introduce otro problema. Recibirlo no deja por sí solo una prueba reproducible del proceso, aunque la respuesta sea útil y esté bien presentada.
Para quien lleva años utilizando una terminal, nada de esto resulta especial; para quien nunca ha trabajado allí, la experiencia puede seguir pareciendo ajena. Entonces aparecen palabras como Python, paquetes, pip install, scripts o entornos virtuales, y la reacción resulta comprensible: «Esto ya es programación; mejor que lo haga el agente».
La alternativa, además, es muy cómoda. Basta con abrir un chat y pedir: «Toma estos archivos, compáralos, revisa los datos, haz los cálculos y entrégame un informe». El agente trabaja y, muchas veces, produce exactamente lo que se necesitaba.
El problema no está en delegar. Está en no distinguir entre recibir un resultado y conservar una capacidad. Una conversación puede resolver el trabajo de hoy; un proceso que queda en archivos, reglas, pruebas y documentación puede seguir resolviéndolo mañana.
La barrera real quizá no sea aprender a programar
No hace falta empezar diciendo: «Escríbeme un programa en Python». De hecho, puede que ni siquiera sea evidente que Python sea una buena herramienta para el trabajo. Si el agente recibió veinte archivos, extrajo datos, limpió valores, hizo validaciones y produjo un informe, una pregunta más útil puede ser mucho más sencilla:
«¿Usaste algún programa o script para hacer esto?»
Si la respuesta es sí, la siguiente petición cambia la naturaleza de la conversación:
«Dame los archivos que utilizaste, entrégamelos en un ZIP y explícame cómo puedo ejecutarlos en mi computadora.»
Ya no se trata de «aprender programación» en abstracto; se trata de recuperar lo que ocurrió detrás de escena para poder repetirlo. Tal vez aparezcan un archivo .py, un requirements.txt, una carpeta de datos y unas instrucciones. Puede que también haga falta instalar dependencias o crear un entorno aislado; la Python Packaging User Guide recomienda precisamente usar entornos virtuales cuando se trabaja con paquetes de terceros, para mantener las dependencias separadas entre proyectos.
En Windows, el recorrido podría reducirse a algo parecido a esto:
py -m venv .venv
.venv\Scripts\activate
py -m pip install -r requirements.txt
py procesar_archivos.py
No hace falta memorizar esos comandos para obtener valor de ellos. Lo importante es comprender qué representan: preparar un entorno, instalar lo que el programa necesita y ejecutar una herramienta que ya existe.
La pantalla negra deja entonces de ser «el lugar donde programan otros» y se convierte en algo mucho más concreto: una interfaz desde la cual se puede ejecutar, observar y repetir un proceso.
Un buen resultado todavía no es una capacidad reproducible
Aquí aparece una diferencia que se vuelve más importante a medida que el trabajo crece. Un agente puede interpretar una instrucción correctamente hoy y elegir otra estrategia mañana; puede utilizar otra herramienta, reorganizar pasos o resolver una excepción con un razonamiento distinto. Eso no significa necesariamente que esté funcionando mal: significa que estamos usando un sistema capaz de tomar decisiones dinámicas.
Ese razonamiento es valioso cuando el problema realmente necesita exploración; no todas las partes del proceso, sin embargo, necesitan volver a descubrirse en cada ejecución. Si todos los lunes llega el mismo tipo de archivo y siempre deben aplicarse las mismas quince comprobaciones, quizá la pregunta correcta ya no sea «¿puede hacerlo el agente?», sino otra:
¿Qué parte de lo que acaba de hacer puede conservarse para no tener que volver a descubrirla la próxima vez?
Es la misma frontera que aparece cuando una tarea está «terminada» desde la perspectiva del agente, pero todavía necesita aceptación funcional. En «La IA dijo “terminado”. El producto tenía otra opinión» la cuestión era verificar que la implementación cumpliera realmente la intención; aquí el siguiente paso consiste en conservar aquello que ya fue validado para que no dependa otra vez de una interpretación nueva.
Cuando hay números, plausibilidad no basta
Supongamos que un valor original era 1.25, pero durante una extracción terminó convertido en 12.5. A partir de allí, todo lo demás puede ejecutarse correctamente: las sumas pueden estar bien, los porcentajes pueden ser impecables, la gráfica puede verse profesional y el análisis puede sonar completamente coherente.
El problema es que todo está construido sobre el dato equivocado.
NIST utiliza el término confabulation para describir casos en los que un sistema generativo produce y presenta con confianza contenido erróneo o falso. Su Generative AI Profile advierte, además, que esa confianza puede inducir a las personas a confiar indebidamente en la salida. Por eso, en procesos numéricos o de alto impacto, la fluidez de una explicación no sustituye una comprobación objetiva.
Si una factura debe satisfacer:
subtotal + impuestos - descuentos = total
el sistema puede verificarlo. Si deben existir exactamente 187 registros, puede comprobarse el conteo. Si débitos y créditos deben coincidir, la ejecución puede detenerse mientras no cuadren; si un valor nunca puede ser negativo, una validación puede bloquear el proceso cuando aparezca uno.
La diferencia entre «los datos parecen consistentes» y «se ejecutaron doce validaciones y las doce fueron superadas» no es de estilo: el primer mensaje es una apreciación; el segundo aporta evidencia. La propia guía del NIST AI RMF insiste en procesos de test, evaluación, verificación y validación —TEVV— que sean repetibles, trazables y documentados.
En un sistema numérico, convincente nunca debería ser sinónimo de correcto.
El conocimiento del dominio es precisamente lo que no conviene entregar
Quien lleva diez años ejecutando un proceso suele saber cosas que un desarrollador externo tardaría meses en descubrir. Sabe qué dato llega mal con frecuencia, qué proveedor utiliza una nomenclatura distinta y cuándo una desviación es normal. También sabe cuándo debe detenerse todo, qué columna jamás puede quedar vacía o qué aparente error, bajo ciertas condiciones, no es realmente un error.
Tal vez ese conocimiento no esté expresado en Python, pero puede expresarse como criterio: «si ocurre esto, detente»; «esa combinación es válida solo en este caso»; «antes de aceptar el resultado, comprueba aquello».
Ahí aparece una división del trabajo mucho más interesante. El agente puede convertir reglas en código, proponer estructuras, escribir pruebas o explicar errores; la autoridad sobre lo que el proceso debe hacer sigue perteneciendo a quien conoce el dominio.
No hace falta competir con el agente como programador. Hace falta evitar delegar también el criterio que permite saber si el programa está bien.
Pedir los archivos puede ser suficiente para empezar
Para alguien que nunca ha programado, pedir los artefactos utilizados puede ser una entrada mucho más natural que comenzar por un curso completo. Primero se obtiene un resultado; después se pregunta qué ocurrió detrás, se conserva el código, se ejecuta y se comprueba si reproduce el resultado con otro archivo.
En ese momento la tarea empieza a existir fuera de la conversación.
Quizá la primera versión sea simplemente:
procesar_archivos.py
Eso puede ser suficiente. Pero si el proceso crece —lectura de documentos, validaciones, cálculos, reportes, configuración, manejo de errores— conviene que la estructura también madure:
mi_sistema/
│
├── main.py
├── lectura.py
├── validaciones.py
├── calculos.py
├── reportes.py
├── config/
├── tests/
├── requirements.txt
└── README.md
Ya no se está pidiendo «un Python»; se está construyendo un pequeño sistema. En «De una idea a un producto funcional» desarrollé una idea relacionada: la velocidad con la que la IA produce una primera implementación no elimina arquitectura, pruebas, documentación ni validación. Aquí ocurre lo mismo a escala personal: la comodidad de delegar la primera ejecución no debería impedir que el resultado se convierta en una capacidad mantenible.
Una versión validada cambia la relación con el agente
Supongamos que la versión 1.4 ya funciona y contiene las reglas, pruebas y estructura que se han aceptado. Aunque siga siendo más cómodo pedirle al agente que ejecute el trabajo, ya no hace falta entregarle únicamente los nuevos archivos y describir el procedimiento desde cero; puede recibir también la versión vigente.
La instrucción podría ser:
«Ésta es la versión actual que ya hemos validado. Utilízala para procesar estos nuevos archivos respetando sus reglas y pruebas. Si encuentras un caso que el sistema no contempla, indícamelo y propón una mejora para una próxima versión; no cambies el comportamiento actual sin aprobación.»
La relación cambia porque el agente deja de reconstruir todo el problema. Parte de una base conocida y concentra el razonamiento donde todavía existe incertidumbre. Esa idea se conecta con lo que observé después de miles de ejecuciones en «Después de 8.901 comandos, cambié mi forma de trabajar con agentes». Allí la conclusión fue que no toda la información merece volver a entrar en contexto ni toda decisión necesita repetirse; una buena arquitectura conserva lo estable y recupera solo lo necesario.
La versión vigente empieza a funcionar como memoria operativa del proceso. No porque recuerde una conversación, sino porque materializa decisiones: reglas, pruebas, dependencias, documentación y comportamiento aceptado.
Operar y mejorar no deberían ser la misma acción
La diferencia se vuelve práctica al distinguir dos trabajos que con frecuencia se mezclan:
OPERAR
usar la versión vigente
→ procesar
→ validar
→ entregar resultado
frente a:
MEJORAR
detectar una excepción
→ analizarla
→ proponer un cambio
→ validar
→ añadir una prueba
→ crear una nueva versión
Si hoy hace falta un informe, probablemente convenga que el sistema produzca el informe; no necesariamente que rediseñe tres reglas durante la ejecución porque encontró una alternativa que parece mejor. Primero se opera. Si surge algo nuevo, se registra; después se decide si merece incorporarse a la siguiente versión.
Un agente puede ser especialmente útil en ese borde: analizar una excepción que el sistema no conoce, comparar posibilidades y ayudar a convertir el aprendizaje en una regla verificable. Una vez que la regla queda entendida y validada, puede pasar a formar parte del software.
El ciclo termina pareciéndose a esto:
caso conocido
→ software

caso nuevo
→ agente + experto
→ comprensión
→ regla
→ prueba
→ nueva versión
→ software
La IA no desaparece; se desplaza hacia aquello que todavía requiere razonamiento.
Reconstruir el mismo camino también tiene un costo
Cuando un agente recibe la misma tarea sin una base reutilizable, puede volver a analizar el problema, elegir herramientas, crear código auxiliar, ejecutar pasos intermedios y verificar resultados. Desde fuera se ve actividad inteligente —y lo es—, pero también hay tiempo, contexto, razonamiento y coordinación involucrados.
Si cada lunes un agente, o incluso un conjunto de agentes, reconstruye prácticamente el mismo recorrido para producir el mismo resultado, tal vez no haga falta mejorar indefinidamente el enjambre. Tal vez convenga preguntarse por qué el recorrido sigue reconstruyéndose.
Hay una diferencia sencilla entre resolver otra vez un procedimiento y ejecutar uno que ya fue validado. Cuando la respuesta ya está suficientemente entendida, convertirla en software libera al agente para trabajar en la frontera nueva. Esa es también la pregunta arquitectónica detrás de «¿Realmente necesitamos otro agente de IA… o el sistema ya debería saberlo?».
Eso es alfabetización técnica, no una carrera de programación
Durante años, construir software parecía inseparable de saber escribir cada línea de código. La IA introduce otra posibilidad: profesionales de otras disciplinas pueden adquirir suficiente alfabetización técnica para gobernar software construido con ayuda de agentes, sin convertirse por ello en desarrolladores tradicionales.
Esa alfabetización no exige memorizar bibliotecas ni comandos. Exige comprender unas pocas ideas importantes: qué entra y qué sale; qué significa que una validación falle; para qué sirve un log; qué protege una prueba y por qué conviene conservar versiones. También exige distinguir qué dependencias necesita el sistema, qué comportamiento está aprobado y cuál todavía está en discusión.
Poco a poco cambia incluso la forma de pedir ayuda. «Haz que funcione» se transforma en «si falta este dato, detente»; «no cambies esta regla»; «añade una prueba para este caso» y «registra lo ocurrido». Después aparecen criterios más precisos: «no inventes un valor cuando no exista»; «antes de generar el informe, comprueba que los totales coincidan».
No se está aprendiendo únicamente a usar una terminal. Se está aprendiendo a definir cómo debe comportarse un sistema y qué evidencia exige su aceptación.
El viejo ciclo de ingeniería sigue funcionando
Nada de esto requiere inventar una metodología nueva. La lógica se parece mucho al ciclo Plan-Do-Check-Act: planificar, ejecutar, comprobar y mejorar. ISO describe el PDCA aplicado a procesos precisamente como una forma de gestionar y mejorar el desempeño; los agentes pueden acelerar varias etapas, pero el aprendizaje útil no tiene por qué quedarse encerrado en la conversación.
Puede convertirse en una regla, una prueba, un archivo de configuración, una versión o una pieza de documentación. En otras palabras: el sistema puede acumular conocimiento.
Ese detalle cambia mucho la relación con la IA. El agente deja de ser únicamente alguien a quien se encarga una ejecución cada vez que aparece el problema; también puede ayudar a construir, ejecutar y mejorar capacidades que permanecen cuando la conversación termina.
La próxima vez que aparezca la pantalla negra
Tal vez PowerShell siga sin resultar agradable. Quizá nunca exista interés en memorizar sus comandos y todavía haga falta pedir ayuda cuando aparezca un error. No importa: el objetivo no es enamorarse de una terminal, sino reducir la distancia entre el conocimiento del dominio y la capacidad de convertir parte de ese conocimiento en algo reproducible.
El primer paso ni siquiera tiene que ser «voy a aprender Python». Puede ser algo mucho más pequeño:
«¿Qué utilizaste para hacer esto? Dame los archivos y enséñame a ejecutarlos.»
Y, cuando exista una versión validada:
«Usa esta versión para hacer el trabajo. Si aparece algo nuevo, indícamelo; no cambies lo que ya funciona sin que podamos volver a validarlo.»
Esa diferencia parece menor, pero cambia la dirección de la delegación. La IA sigue haciendo gran parte del trabajo; el proceso, sin embargo, deja de desaparecer cuando termina la conversación.
Quizá, para muchas personas, una nueva forma de alfabetización técnica empiece con algo tan sencillo como no cerrar esa pantalla negra la próxima vez que aparezca.