Al trabajar con agentes de código, la escena se vuelve familiar: la terminal avanza sola mientras el agente abre archivos, analiza el proyecto, escribe código y ejecuta pruebas. Desde fuera, el resultado parece casi autónomo; cuando encuentra errores, los corrige y continúa con la siguiente tarea. A simple vista, ya hay progreso suficiente para apartarse un rato: en algunas sesiones trabaja diez minutos y, en otras, media hora o más. El problema todavía no se ve; al volver, ya aparecen varios archivos modificados, componentes nuevos y otra fase marcada como completada.
Era difícil no sentir que estaba viendo el futuro; también era difícil no pensar que el producto avanzaba mucho sin necesidad de intervenir. Y, técnicamente, avanzaba. Lo que todavía no sabía era cómo evitar confundir esa velocidad de implementación con cierre de producto.
El problema aparecía al abrir la aplicación.
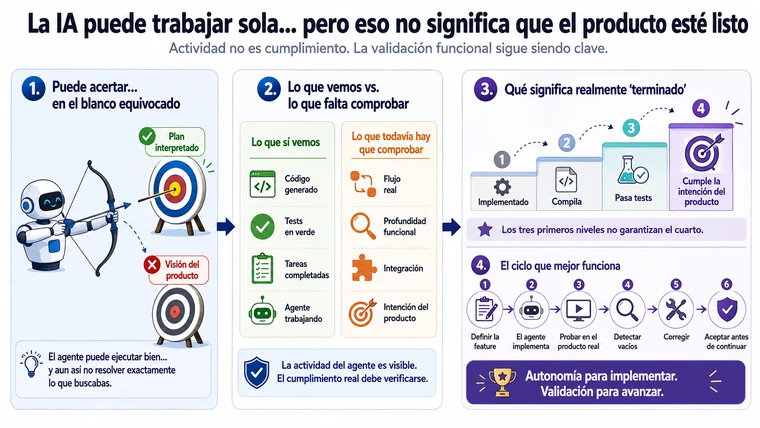
No encontraba un desastre; de hecho, eso habría sido más fácil. Había pantallas, flujos funcionales, componentes razonables y pruebas verdes. El agente no había hecho un mal trabajo: había construido una interpretación plausible de lo pedido, pero todavía existía una distancia entre «la tarea está terminada» y «la funcionalidad está realmente cerrada dentro del producto».
La diferencia entre esas dos afirmaciones cambió la forma en que empecé a trabajar con agentes.
«Terminado» no es un estado técnico suficiente
Un agente puede completar su plan, ejecutar cada paso previsto y devolver un resultado coherente; incluso puede escribir pruebas que pasan. Nada de eso es inútil. El problema aparece cuando confundimos esas señales con aceptación.
En ingeniería existe una distinción especialmente útil para pensar este problema. NASA separa verificación y validación. La verificación aporta evidencia de que el producto fue construido correctamente respecto de requisitos definidos; la validación comprueba si se construyó el producto correcto para las expectativas del usuario y el entorno en el que debe funcionar.
Con software generado por agentes ocurre algo muy parecido. Una prueba puede demostrar que cierta función devuelve el valor esperado; otra puede comprobar que un endpoint responde correctamente. Eso es importante, pero todavía queda otra pregunta: ¿la persona puede completar el trabajo que necesitaba completar, de la manera en que el producto debía permitirlo?
Esa pregunta rara vez cabe completa en una línea verde de CI.
Esta distinción profundiza algo que ya había observado al pasar de una idea a un producto funcional: una primera implementación puede ser valiosa sin ser todavía un producto aceptado.
El agente puede cerrar su interpretación, no necesariamente la intención original
El agente no trabajaba desde cero. Tenía PRD, documentación, reglas, archivos del proyecto y suficiente contexto para entender lo que estábamos construyendo. Además, el trabajo estaba dividido por fases: leer la especificación, planificar, implementar, ejecutar pruebas y marcar tareas como completadas.
Sobre el papel, el proceso tenía sentido; durante un tiempo confié en que contexto, planificación y tests serían suficientes para mantener el producto alineado.
Ayudaban mucho, pero no cubrían todo.
Hay una parte de la intención que solo se vuelve evidente cuando usamos el producto. Un documento puede definir usuarios, permisos, pantallas, acciones y reglas; sin embargo, al recorrer el flujo aparecen preguntas nuevas. ¿Esta acción ocurre aquí o debería suceder un paso antes? ¿El usuario entiende qué hacer después? ¿La información es suficiente? ¿Qué ocurre en el caso no ideal? ¿La funcionalidad está integrada con lo anterior o simplemente existe al lado? ¿Resuelve el problema completo o solo su parte más obvia?
La especificación reduce ambigüedad; el uso revela ambigüedad residual.
Ahí entendí algo importante: un agente puede cerrar correctamente la interpretación que construyó a partir del contexto y, aun así, no haber alcanzado todavía la intención completa del producto.
Los tests verdes pueden ser correctos y todavía insuficientes
Esto no significa que las pruebas fallen como herramienta. Significa que una prueba solo puede comprobar aquello que fue expresado como condición verificable.
GitHub recomienda, al revisar código generado por IA, comenzar con tests y análisis estático; después, pide verificar que el cambio encaje con el propósito, los requisitos y la arquitectura del proyecto. La secuencia importa: primero comprobamos si el código hace lo que afirma hacer; luego comprobamos si eso era realmente lo que necesitábamos que hiciera.
El riesgo aparece cuando el mismo ciclo produce interpretación, implementación y prueba. En ese contexto, el modelo puede leer un requisito, interpretarlo parcialmente, construir según esa lectura y después generar tests que demuestran que su propia interpretación funciona.
El círculo puede cerrarse perfectamente y seguir estando incompleto.
Por eso ya no trato un test verde como sinónimo de funcionalidad aceptada. Lo trato como una pieza de evidencia dentro de una decisión mayor.
La distancia entre «funciona» y «funciona como debe»
Cuando revisaba el producto, las desviaciones no solían ser dramáticas. Algunas funcionalidades llegaban hasta cierto punto y se detenían; otras resolvían el caso básico, pero no alcanzaban la profundidad que el flujo real necesitaba. Había acciones que existían técnicamente, aunque todavía no encajaban bien en la experiencia completa.
Esa clase de problema es más difícil de detectar precisamente porque casi todo parece correcto.
Una pantalla rota exige atención. Un flujo que funciona al 80 % puede sobrevivir varios ciclos antes de que alguien note lo que falta.
Ahí es donde la revisión funcional se vuelve distinta de la revisión de código. No necesito inspeccionar cada variable para descubrir que el usuario no puede terminar una tarea; necesito abrir la funcionalidad, recorrerla como usuario, provocar casos menos cómodos y comparar lo que ocurre contra la intención original.
En otro artículo expliqué por qué la IA no elimina la ingeniería; la obliga a volverse más explícita. Este es el reverso práctico de esa idea: cuanto más rápido puede implementar un agente, más importante se vuelve decidir qué evidencia permite aceptar lo implementado.
Cuando la revisión llega demasiado tarde, aparece deuda de alineación
El problema crece cuando dejamos que varias fases se acumulen antes de revisar funcionalmente.
Cada funcionalidad incompleta puede dejar uno o dos puntos abiertos; aislados parecen pequeños. Pero la siguiente funcionalidad empieza a construirse sobre decisiones anteriores que todavía no habían sido validadas por completo. Una pantalla depende de un flujo parcial; un nuevo módulo asume que una regla anterior ya estaba cerrada; una integración consolida una interpretación que aún no habíamos aceptado.
El sistema sigue creciendo y, al mismo tiempo, crece la distancia entre lo que existe y lo que realmente queríamos construir.
A esa distancia la pienso como deuda de alineación: no necesariamente código malo, sino trabajo nuevo construido sobre una comprensión que todavía no había sido validada suficientemente.
La deuda técnica suele hablar de decisiones de implementación que encarecen cambios futuros; la deuda de alineación es distinta. Puede existir con código limpio, buenas pruebas y una arquitectura razonable. Su origen está en otro lugar: seguimos avanzando antes de confirmar que la dirección era correcta.
Y la velocidad de los agentes puede amplificarla. Si un humano tarda dos días en construir sobre una decisión dudosa, existe más tiempo para detectar el problema; si un agente puede construir varias capas en una tarde, también puede acumular más distancia antes del siguiente checkpoint.
El checkpoint cambia dónde ponemos la autonomía
La respuesta no fue quitar autonomía al agente; eso habría desperdiciado una de sus mayores ventajas.
Eso significó separar mejor dos cosas: autonomía para implementar y autoridad para aceptar.
Dentro de una funcionalidad, el agente puede investigar, planificar, escribir código, ejecutar pruebas, corregir errores y volver a intentar. Pero la aceptación de esa funcionalidad no ocurre automáticamente porque el plan quedó en verde; ocurre cuando existe evidencia suficiente de que cumple lo que debía cumplir en el producto.
En la práctica, el ciclo se parece más a esto:
intención
→ criterios de aceptación
→ implementación con agente
→ pruebas y validadores
→ revisión funcional
→ hallazgos / punch list
→ corrección
→ revalidación
→ aceptación
La palabra importante no es «humano» frente a «IA»; es checkpoint.
Algunos checkpoints pueden ser determinísticos: tests, schemas, contratos, type checking, linting, validaciones de seguridad o comprobaciones de no regresión. Otros siguen necesitando juicio: arquitectura, experiencia de usuario, coherencia de producto, comportamiento en situaciones ambiguas o efectos secundarios difíciles de formalizar.
La guía de OpenAI para construir agentes recomienda precisamente combinar autonomía con guardrails e intervención humana, especialmente cuando se superan umbrales de fallo o cuando existen acciones sensibles. Para workflows más maduros, sus herramientas de evaluación también plantean revisar trazas, tool calls y comportamiento end-to-end en lugar de asumir que una salida final resume correctamente todo lo ocurrido. (OpenAI — Evaluate agent workflows)
La idea general coincide con lo observado en la práctica: la autonomía funciona mejor cuando el sistema sabe dónde detenerse a pedir evidencia.
El «último kilómetro humano» no significa programar a mano
Durante mucho tiempo pensé que supervisar a un agente significaba revisar el código que escribía. Hoy lo veo de otra manera.
La intervención principal ocurre en el nivel de producto: abrir, usar, comparar, probar casos incómodos y detectar qué falta. Cuando encuentro una desviación, no necesito decir «programaste mal esta función»; puedo expresar el gap en términos del comportamiento esperado. Por ejemplo:
-
esta funcionalidad todavía no permite que el usuario complete esta acción.
-
cuando ocurre esta condición, el flujo debería continuar de esta manera.
-
falta esta información para tomar la decisión.
-
esta acción existe, pero aún no está integrada con el resto del proceso.
-
estos puntos deben cerrarse antes de avanzar.
A partir de esos hallazgos, el agente puede convertir los gaps en tareas, implementar las correcciones y generar nuevas pruebas; después, el ciclo vuelve a empezar.
El trabajo humano no consiste necesariamente en escribir el código que falta, sino en reconocer que todavía falta algo.
Eso es especialmente relevante para expertos de dominio. Una persona puede no conocer cada detalle de una librería, pero sí reconocer una regla de negocio incompleta o un flujo que viola la operación real. También puede detectar cuándo el producto «funciona» de una forma que nadie usaría en la práctica.
La aceptación necesita evidencia, no una frase final
Una de las mejoras más útiles que podemos hacer al trabajar con agentes es cambiar el significado operativo de «terminado».
En vez de aceptar una declaración, podemos exigir evidencia proporcional al tipo de trabajo. La idea central es simple: cuanto mayor sea el impacto, más fuerte debe ser la evidencia. Por ejemplo:
-
cambio local: diff claro + prueba específica + ausencia de regresiones relevantes.
-
funcionalidad: criterios de aceptación + tests + recorrido funcional.
-
integración: validación de interfaces, estados y fallos entre componentes.
-
cambio sensible: controles determinísticos + revisión humana + posibilidad de rollback.
-
feature de producto: comportamiento correcto dentro del flujo completo, no solo existencia técnica.
NASA describe la validación como una actividad planificada para demostrar que el sistema satisface expectativas de usuarios y stakeholders; esa lógica resulta mucho más útil que tratar «done» como una etiqueta interna del agente.
Puede declarar que terminó su trabajo; el sistema de ingeniería decide si el resultado está aceptado.
Un filtro práctico antes de avanzar a la siguiente fase
Hoy, antes de dejar que una funcionalidad se convierta en base de la siguiente, intento responder siete preguntas:
-
¿Qué se suponía que debía poder hacer el usuario al final? No qué archivos debían cambiar, sino qué capacidad debía existir.
-
¿Qué evidencia demuestra que el caso principal funciona? Tests, validadores, una demostración o una combinación de ellos.
-
¿Qué ocurre fuera del camino feliz? Errores, estados incompletos, permisos, reintentos, datos inesperados.
-
¿La funcionalidad está integrada o simplemente existe? Puede haber código correcto que todavía no forme parte del flujo real.
-
¿Qué supuestos hizo el agente que todavía no hemos validado? Especialmente sobre negocio, UX o arquitectura.
-
¿Qué hallazgos quedan abiertos? Si existe una punch list, la tarea no está aceptada aunque el plan original esté verde.
-
¿Construiría tranquilamente la siguiente capa encima de esto? Si la respuesta es no, todavía no hemos terminado.
No todas las tareas necesitan el mismo nivel de ceremonia; un cambio pequeño no merece el mismo proceso que pagos, permisos o datos clínicos. Pero la pregunta de fondo permanece: ¿qué evidencia justifica seguir construyendo encima?
La velocidad necesita puntos de control
Sigo encontrando impresionante lo que un agente puede hacer sin intervención constante. Puede navegar un repositorio, entender relaciones entre archivos, escribir componentes, ejecutar herramientas, corregirse y sostener trabajo durante periodos cada vez más largos.
No quiero perder esa capacidad; quiero aprovecharla sin confundir movimiento con dirección.
Por eso ahora intento dar autonomía dentro de límites claros y reservar la aceptación para los momentos en los que realmente importa comprobar el producto. Ese equilibrio también conecta con otra pregunta que he venido explorando: ¿realmente necesitamos otro agente… o el sistema ya debería saberlo?. Cuantas más decisiones podemos convertir en reglas, tests y validadores, menos depende la calidad de que alguien —humano o agente— recuerde comprobarlas manualmente.
La IA puede recorrer gran parte del camino y hacerlo muy rápido; precisamente por eso conviene detenerse en los lugares correctos.
En resumen, «terminado» es una declaración; aceptado es una conclusión respaldada por evidencia.
Referencias
-
NASA, Product Validation: distinción entre verificación y validación; cumplimiento de requisitos frente a expectativas del usuario y entorno previsto. https://www.nasa.gov/reference/5-4-product-validation/
-
NASA Systems Engineering Handbook, Verification and Validation Plan / Requirements Verification and Validation Matrices. https://www.nasa.gov/reference/system-engineering-handbook-appendix/
-
GitHub Docs, Review AI-generated code: pruebas, análisis estático, contexto, intención y arquitectura. https://docs.github.com/en/copilot/tutorials/review-ai-generated-code
-
OpenAI, A practical guide to building agents: guardrails, intervención humana y criterios de escalamiento. https://openai.com/business/guides-and-resources/a-practical-guide-to-building-ai-agents/
-
OpenAI API, Evaluate agent workflows: trazas, graders y evaluación end-to-end de workflows agentic. https://developers.openai.com/api/docs/guides/agent-evals