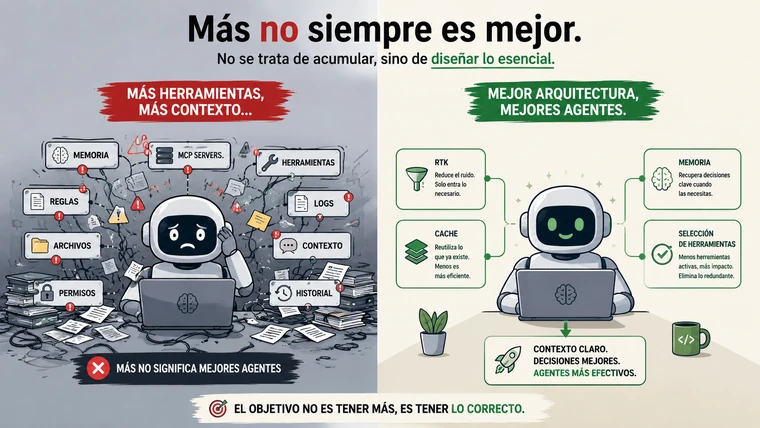
Durante bastante tiempo, mejorar el trabajo con agentes parecía significar una sola cosa: darles más capacidad. El resultado parecía obvio: un modelo mejor, otra herramienta, más memoria, más acceso al repositorio o más contexto debían producir un agente más competente.
Después de varias semanas de uso intensivo y de revisar los datos de 8.901 comandos, apareció un problema distinto: cada nueva capacidad también podía introducir ruido, repetir información o consumir contexto que no aportaba suficiente valor. Para equipos que trabajan durante horas con agentes, reducir ese desperdicio puede dejar más capacidad disponible para el problema real.
La pregunta cambió. Ya no era únicamente «¿qué más puede hacer el agente?»; empezó a ser «¿qué parte de todo lo que puede recibir merece realmente ocupar su atención?». Esa diferencia parece pequeña, pero terminó modificando la arquitectura completa del flujo de trabajo.
El primer cuello de botella dejó de ser el modelo
Cuando los modelos eran menos capaces, era natural atribuir muchos fallos a la inteligencia disponible. Con modelos de razonamiento más fuertes, capaces de navegar un repositorio, ejecutar comandos, revisar Git, lanzar pruebas, inspeccionar logs y corregir una implementación durante varias iteraciones, el problema empezó a desplazarse.
Un agente de desarrollo no solo «piensa»: interactúa constantemente con un entorno que puede devolver cantidades enormes de información. Un git diff, una suite de pruebas, un listado recursivo, un log o una búsqueda amplia pueden producir cientos o miles de líneas. Si todo ese material entra en bruto, el modelo recibe más contexto; no necesariamente recibe más señal.
Ese matiz está muy cerca de lo que Anthropic denomina context engineering. El problema ya no consiste únicamente en redactar mejores prompts; también exige decidir qué información entra en la ventana de contexto, cuándo entra y cuánto valor aporta. Su recomendación central es especialmente útil para pensar agentes de larga duración: buscar el conjunto más pequeño posible de tokens de alta señal que aumente la probabilidad de obtener el resultado deseado.
La consecuencia práctica es incómoda porque añadir información puede ayudar, pero también puede diluir la atención. En lugar de preguntar cuánto contexto cabe, conviene preguntar cuánto contexto merece permanecer activo.
8.901 comandos terminaron funcionando como una auditoría
RTK entró en el flujo con una función relativamente simple: reducir la salida de determinados comandos antes de que llegara al agente. Si una operación devolvía cientos o miles de líneas, la capa intentaba conservar la señal útil y evitar que todo el resultado crudo terminara ocupando contexto.
Después de unas cinco semanas, las estadísticas acumuladas mostraban 8.901 comandos procesados, con 90,4 millones de unidades de entrada potencial, 14,6 millones finalmente entregadas y 75,9 millones evitadas; la reducción registrada era del 83,9 %. En la semana más reciente de aquella muestra llegó al 87,1 %.
Conviene ser preciso con lo que esos números significan. No demuestran que una factura haya bajado un 83,9 % ni que una cuota semanal vaya a durar automáticamente un 83,9 % más. Las políticas de uso, el caching, los modelos y la forma de contabilizar capacidad son problemas distintos. Lo que sí mostraban era más concreto: una gran cantidad de información potencialmente disponible no necesitaba entrar completa en el contexto para que el trabajo continuara.
Hasta que miré las estadísticas, el costo del ruido seguía siendo bastante abstracto. RTK no hizo más inteligente al modelo; funcionó, en ese flujo, como una especie de control de admisión: antes de gastar atención leyendo una salida extensa, aparecía una pregunta implícita —¿cuánto de esto necesita realmente el agente?—.
Ese fue el primer cambio importante: dejar de asumir que «más contexto» y «mejor contexto» eran sinónimos.
Después apareció otro problema: lo repetido
Reducir lo que entra resuelve una parte del problema, no todas. Hay información que sí debe estar presente: instrucciones estables, definiciones de herramientas, reglas del proyecto, parte del historial y referencias que se reutilizan durante muchas llamadas.
Ahí el caching empieza a importar por una razón distinta. La documentación de OpenAI sobre prompt caching explica que, cuando varias solicitudes comparten un prefijo estable, parte del procesamiento previo puede reutilizarse; eso puede reducir latencia y costo de entrada en los casos compatibles. La misma documentación hace una precisión importante: mantener una sesión no implica, por sí solo, que vaya a producirse un cache hit.
Por eso empecé a separar dos preguntas que antes tendían a mezclarse:
- ¿esta información debe entrar?
- si debe entrar repetidamente, podemos evitar tratarla cada vez como si fuera nueva?
RTK atacaba principalmente la primera. El caching atacaba la segunda.
Al revisar Headroom, esa diferencia se volvió evidente. La compresión directa que observaba no parecía espectacular frente al volumen total; en cambio, el uso elevado del prefix cache y la persistencia de decisiones útiles empezaron a resultar más interesantes. La herramienta había entrado al stack, en buena medida, por la promesa de optimizar contexto; terminó ganando valor también por continuidad.
No porque hubiese inventado el caching —los proveedores ya ofrecen mecanismos propios—, sino porque el problema de fondo era más amplio. La diferencia estaba en organizar el contexto para que la información estable pudiera reutilizarse sin reconstruirla innecesariamente.
Guardar memoria tampoco basta
En aquel proyecto aparecían 256 memorias persistentes, con una importancia media de 0,86 y registros que alcanzaban 27 días de antigüedad. Más que el número, importaba su contenido: restricciones, decisiones funcionales, criterios de diseño y acuerdos que seguían teniendo consecuencias semanas después.
Eso resolvía continuidad entre sesiones, pero no otro problema que se vuelve visible durante jornadas largas. Una conversación puede comenzar perfectamente orientada y, horas después, haber acumulado herramientas, errores, correcciones, nuevos archivos y decisiones intermedias. Que una regla haya estado presente al principio no implica que siga siendo la pieza más saliente cuando vuelva a ser necesaria.
Por esa razón había creado Quick Context, una skill deliberadamente pequeña. No intentaba almacenar todo el proyecto ni competir con una memoria persistente. Su trabajo era reubicar al agente: identificar el proyecto, localizar sus reglas, recuperar restricciones y permisos, revisar cambios recientes y restablecer la posición desde la que debía continuar.
La diferencia terminó pareciéndome útil:
memoria persistente conserva conocimiento; reorientación recupera posición.
Anthropic describe un patrón parecido al hablar de structured note-taking y recuperación just-in-time. En tareas largas, parte del conocimiento puede persistir fuera de la ventana y volver a cargarse cuando resulta relevante, en lugar de mantenerse activo durante cada turno.
Eso también cambió una intuición anterior. Cargar mucha información al comienzo de una sesión puede producir un buen arranque; no implica que el agente conserve la información correcta, con la relevancia correcta, horas después.
La pregunta dejó de ser «¿cuánta memoria puedo cargar?» y pasó a ser «¿puedo recuperar la pieza adecuada cuando vuelve a importar?».
Una herramienta puede ser buena y seguir sobrando
La siguiente sorpresa no vino de una herramienta que fallara, sino de una que todavía no había justificado su lugar.
Headroom incluía Serena como capa de code memory y navegación semántica. Sobre el papel tenía sentido; el problema era que el stack ya contenía otras rutas para cubrir partes similares de la necesidad: Codebase MCP Memory, CocoIndex Code, Graphify, búsqueda textual, filesystem y Git.
Mientras tanto, veía procesos de Serena levantándose sin estar utilizando conscientemente esa capacidad. No era evidencia de que Serena fuese una mala herramienta; era evidencia de algo más útil para gobernar el stack: instalar una capacidad no demuestra que esa capacidad deba permanecer activa.
La desactivé del flujo diario y dejé abierta una evaluación posterior, idealmente controlada: comparar qué aporta frente a CocoIndex, qué sustituye, qué duplica y cuánto contexto o complejidad operacional introduce.
Anthropic formula una advertencia parecida desde otro ángulo: los toolsets demasiado grandes o con funciones solapadas crean puntos de decisión ambiguos. Si ni siquiera un ingeniero puede decir con claridad qué herramienta corresponde en una situación determinada, no es razonable esperar que el agente resuelva mejor esa ambigüedad de forma consistente.
Ahí apareció una regla que ahora me resulta más útil que «añadir capacidades»: cada herramienta debería ganarse su lugar.
MCP tampoco tiene que ser la respuesta automática
Algo similar ocurrió con MCP. No llegué a la conclusión de que fuera una mala arquitectura; al contrario, sigue siendo muy útil cuando hace falta una integración rica, persistente, estructurada o con capacidades que no conviene reconstruir mediante shell.
Pero algunas operaciones eran pequeñas, locales y perfectamente expresables mediante CLI. Si podían ejecutarse de esa forma y, además, la salida podía filtrarse antes de llegar al modelo, aparecía una alternativa más simple: no mantener otra integración activa únicamente porque estuviera disponible.
El criterio dejó de ser «MCP o CLI» como una discusión de bandos. Empezó a ser una pregunta de ingeniería:
¿qué interfaz entrega suficiente capacidad con la menor cantidad de fricción, ambigüedad y contexto innecesario para esta operación?
A veces la respuesta será MCP; otras veces, CLI, una función específica, una búsqueda textual o una llamada directa a una API. La diferencia está en escoger la superficie adecuada, no en convertir una tecnología en religión.
El stack empezó a parecerse a una arquitectura de contexto
Al mirar todas esas decisiones juntas, dejaron de parecer optimizaciones independientes. En realidad estaban respondiendo cuatro preguntas diferentes:
- ¿Qué información entra? Reducir ruido antes de que ocupe atención.
- ¿Qué información se repite? Aprovechar caching cuando existen prefijos realmente reutilizables.
- ¿Qué información debe sobrevivir? Guardar decisiones duraderas fuera de la conversación inmediata.
- ¿Qué información debe recuperarse ahora? Traer contexto just-in-time, según la tarea y el punto del proyecto.
Añadiría una quinta, que terminó siendo igual de importante:
- ¿Qué herramientas merecen seguir activas? Conservar capacidades únicas; cuestionar duplicaciones y costes operacionales.
El punto ya no era ahorrar tokens por ahorrar tokens. La diferencia no está entre mucho contexto y poco contexto, sino entre contexto que merece atención y contexto que simplemente la ocupa. Eso importa porque la capacidad del modelo debería gastarse, en la medida de lo posible, en el problema y no en la infraestructura que rodea al problema.
Esa idea conecta con algo que ya había observado al pasar de una idea a un producto funcional: la velocidad de generación no elimina la necesidad de arquitectura. También conecta con el problema de aceptar trabajo demasiado pronto; como contaba en La IA dijo «terminado». El producto tenía otra opinión, la autonomía funciona mejor cuando el sistema define qué información, evidencia y controles necesita cada etapa.
Cinco preguntas antes de añadir otra capa
Hoy, antes de mantener una nueva herramienta o una nueva fuente de contexto dentro del flujo habitual, intento responder cinco preguntas:
-
¿Qué capacidad única añade? Si no puede explicarse con claridad, probablemente todavía no haya demostrado su valor.
-
¿Cuánto contexto introduce para entregar esa capacidad? Una respuesta correcta puede ser demasiado cara si llega acompañada de ruido sistemático.
-
¿Duplica algo que ya existe? Dos herramientas buenas pueden formar una mala arquitectura cuando cubren lo mismo sin una frontera clara.
-
¿Esta información necesita estar presente de forma permanente? Si solo importa en determinados momentos, la recuperación just-in-time suele ser más limpia que cargarla de forma permanente.
-
Si la desactivo durante una semana, ¿qué trabajo real deja de poder hacerse? La pregunta obliga a distinguir utilidad demostrada de utilidad imaginada.
No es una fórmula universal. Hay proyectos donde una integración adicional ahorra horas; en otros, mantenerla activa añade más complejidad que capacidad. Ese marco sirve para comparar utilidad demostrada con coste contextual, no para convertir la poda en un objetivo por sí mismo. Lo importante es medir el efecto dentro del sistema real, no enamorarse de la lista de features.
Menos desperdicio antes de buscar más inteligencia
Los modelos seguirán mejorando: crecerán las ventanas de contexto, el caching será más sofisticado y las memorias serán más útiles. También aumentará el acceso a herramientas cada vez más poderosas. Nada de eso elimina la necesidad de decidir qué merece atención.
De hecho, puede volverla más importante. Cuanto más capaz es un agente, más fácil resulta entregarle acceso a todo. Cuanto más acceso tiene, más importante se vuelve diseñar fronteras que separen señal de ruido, conocimiento persistente de contexto momentáneo y capacidad real de redundancia acumulada.
Después de 8.901 comandos, el cambio más importante no fue descubrir una herramienta concreta. Fue dejar de pensar el stack como una colección de capacidades y empezar a tratarlo como una arquitectura de contexto.
La idea central es sencilla: la eficiencia de un agente no depende solo de cuánto puede pensar; también depende de cuánto trabajo inútil conseguimos evitar antes de pedirle que piense.
Referencias
- Anthropic — Effective context engineering for AI agents: https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents
- OpenAI — Prompt caching: https://developers.openai.com/api/docs/guides/prompt-caching