Si tú ya trabajas con agentes de IA, quizá reconozcas una tentación: si un agente puede hacerlo, usemos un agente. Tu flujo de trabajo gana otro ayudante capaz, y tu sistema parece avanzar al añadir un agente más.
Pero capacidad no es lo mismo que necesidad.
La pregunta que ahora me resulta más útil es otra: ¿qué parte de tu problema ya conoces suficientemente bien como para dejar de razonarla cada vez?
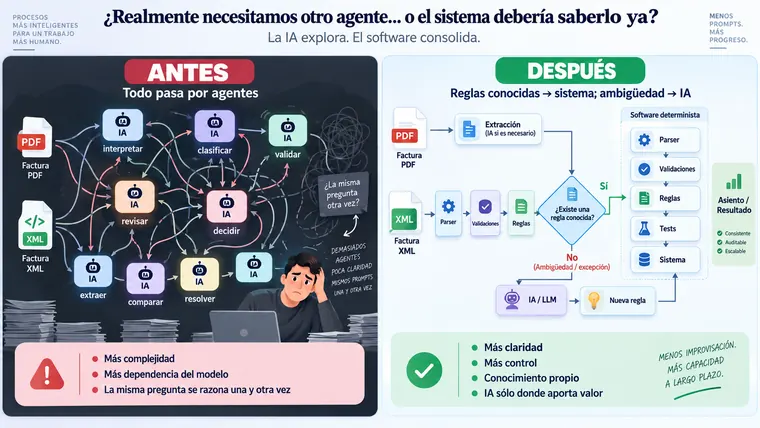
Por ejemplo, una tarea puede ser estable, repetible y verificable de forma objetiva. En ese caso, el software determinístico puede ser una mejor opción. Cuando todavía hay ambigüedad, contexto, excepciones o información no estructurada, un agente de IA empieza a ganarse su lugar.
En otras palabras, no se trata de usar menos IA, sino de usar inteligencia donde todavía existe incertidumbre. Esa frontera se está convirtiendo en una de las decisiones de diseño que más valoro.
Una factura electrónica hace visible la diferencia
Imaginemos una factura electrónica. Si solo recibimos un PDF, una máquina tiene que reconstruir bastante significado. Debe localizar proveedor y cliente, reconocer la tabla, separar impuestos de descuentos y relacionar cada valor con su concepto. Un modelo multimodal puede ayudar mucho en ese escenario.
Ahora añadamos otra entrada: el XML estructurado que acompaña la factura.
De pronto, una parte importante de la interpretación desaparece. El proveedor ya tiene un campo. La fecha tiene un campo. Los impuestos tienen campos definidos. Las líneas de producto tienen jerarquía. Los valores ya vienen asociados con aquello que significan.
Esto no es solo un ejemplo conveniente. El estándar europeo EN 16931 define un modelo semántico para los elementos centrales de una factura electrónica. También vincula ese significado con sintaxis estructuradas como UBL y CII. Eso significa que algunos procesos ya contienen buena parte del significado que una máquina necesita.
Entonces la pregunta cambia: ¿por qué pedirle a un LLM que vuelva a descubrir algo que el sistema ya sabe?
En lugar de pedirle al modelo que reinterprete esos campos, podemos parsear el XML, comprobar totales, aplicar reglas explícitas y transformar los datos a nuestro propio modelo. Si la misma condición debe producir de forma consistente la misma respuesta, podemos comprobarla directamente.
Ahí no necesito creatividad. Necesito certeza.
Agentes de IA vs. software determinístico: dónde aporta valor cada uno
La distinción útil no es «IA contra software tradicional», sino lógica conocida frente a incertidumbre relevante. Software determinístico significa que la respuesta sigue reglas que ya entendemos y podemos probar.
Un mismo workflow puede tener ambas cosas.
Algunas partes pueden estar bien definidas. Podemos comprobar un identificador contra restricciones conocidas. Podemos aplicar una regla de negocio de forma consistente. Podemos verificar un cálculo. Un proceso también puede tener estados y transiciones explícitos.
Luego aparece algo diferente: una descripción ambigua, una clasificación difícil o un caso nuevo para el que todavía no existe una regla. Ahora sí tenemos una pregunta. Ahí la IA resulta mucho más interesante. Puede interpretar, comparar posibilidades y ayudar a investigar información no estructurada. Un humano valida el resultado y el proceso continúa.
Esta frontera también aparece en las guías actuales de quienes construyen estos sistemas. OpenAI recomienda agentes especialmente cuando los enfoques determinísticos o basados en reglas se quedan cortos. También señala que, en otros casos, una solución determinística puede ser suficiente.
Anthropic traza una línea parecida. Los workflows predefinidos aportan previsibilidad y consistencia para tareas bien definidas. Los agentes cobran sentido cuando hacen falta flexibilidad y decisiones dinámicas del modelo.
Eso no nos entrega una fórmula universal. Nos entrega una mejor pregunta.
Cuando una excepción vuelve una y otra vez, se convierte en conocimiento
Supongamos que la misma excepción vuelve a aparecer. Después otra vez. Y otra.
En algún momento deja de ser realmente una excepción. Hemos aprendido algo.
Entonces conviene preguntar si ese aprendizaje debe seguir viviendo solo en una conversación o convertirse en una capacidad permanente del sistema. A eso lo llamamos consolidación: transformar una lección recurrente en algo que el sistema pueda reutilizar. Yo lo pienso así:
conocido → software

desconocido → IA

desconocido recurrente
→ aprendizaje
→ regla
→ prueba
→ software
El agente no desaparece; se desplaza hacia la siguiente frontera. Eso importa porque el sistema conserva la lección mientras el agente sigue explorando.
Hay una frase que me ayuda a recordarlo: la IA explora la frontera; el software consolida el territorio.
Aprender debería dejar algo detrás
Hablamos mucho de memoria de agentes, contexto persistente, historiales y bases de conocimiento. Todo eso puede ser útil. Pero otra forma de memoria suele ser más valiosa en producción: hacer que lo aprendido cambie el sistema.
Si resolvemos una excepción, descubrimos una regla general y la convertimos en código probado, la siguiente ejecución ya no necesita reconstruir toda la conversación. Ese conocimiento quedó absorbido en algo que podemos inspeccionar, probar, versionar y reutilizar.
Eso también cambia cómo entiendo la madurez de un sistema. Mientras todavía estamos explorando, es natural necesitar interpretación. Pero cuando una decisión recurrente se vuelve clara, parte de ese conocimiento puede pasar a reglas, contratos, validaciones, pruebas, schemas y estados explícitos.
No se trata de sacar a la IA del sistema. Se trata de reservarla para donde la inteligencia todavía está haciendo un trabajo real.
NIST da una razón práctica para mantener visible esa frontera. Su perfil de riesgo para IA generativa define la confabulación como contenido falso o erróneo presentado con confianza. También recomienda prácticas de prueba y evaluación, incluidas comparaciones con datos conocidos de referencia cuando corresponde.
Eso no convierte a los LLM en malas herramientas de automatización. Sugiere algo más útil: si existe una comprobación objetiva, úsala.
El modelo puede proponer. El sistema todavía puede verificar.
De una corrección humana a una regla del sistema
Los agentes de programación hacen que esto me resulte especialmente interesante.
Durante años, muchos expertos de dominio conocían procesos técnicamente automatizables pero difíciles o costosos de traducir a software. Sabían qué debía ocurrir, qué excepciones importaban, cuándo un workflow debía detenerse y qué significaba un campo ausente. Llevar ese conocimiento a código funcional seguía exigiendo una larga cadena de traducción.
En mi propio trabajo, los agentes de programación están acortando parte de esa distancia.
Un experto puede colaborar con un agente sin dominar cada librería o detalle de implementación. Pero conserva algo que sigue siendo difícil de delegar: saber cuándo el resultado está mal.
Puede decir: «Esa no es la regla». «Aquí existe una excepción». «Ese campo no significa lo que estás suponiendo». «El proceso debería detenerse aquí».
La parte más valiosa viene después.
Si esa corrección queda únicamente en el chat, aprendimos algo… pero el sistema no necesariamente lo aprendió. Si convertimos la corrección en una regla, prueba, validación o contrato, la siguiente ejecución comienza desde un nivel más alto.
Eso se parece mucho a una idea clásica de ingeniería: Plan, Do, Check, Act. Probar, comprobar, corregir, consolidar y volver a ejecutar el ciclo. ISO describe precisamente PDCA como un ciclo de mejora continua para procesos y sistemas.
La herramienta es nueva; la lógica de mejora continua no tanto.
Esto también forma parte de la progresión que describí en Cómo trabajar mejor con la IA: mejores prompts terminan llevando a mejor contexto, criterios más claros, herramientas, pruebas, workflows y sistemas.
El agente puede cambiar; la capacidad debería permanecer
Hay otra ventaja de consolidar lo aprendido.
Hoy puedo construir con un modelo y mañana cambiar de proveedor. Puede aparecer una herramienta mejor. La arquitectura puede cambiar. Si el conocimiento operativo vive principalmente en prompts, conversaciones y comportamientos particulares del agente, parte del sistema queda atada a esa herramienta.
Pero si durante el trabajo convertimos ese conocimiento en reglas, código, pruebas, schemas, workflows y datos estructurados, la relación cambia.
El agente puede cambiar; la capacidad permanece.
Esa distinción me importa cada vez más. La IA puede ayudar a construir el activo sin tener que convertirse ella misma en el activo. Un modelo puede ayudarnos a descubrir una regla. Cuando la regla ya está clara, prefiero verla, probarla, versionarla y trasladarla.
Antes de añadir otro agente de IA, probaría este filtro
La próxima vez que un workflow parezca necesitar «otro agente», empezaría con cinco preguntas:
- ¿La entrada ya viene estructurada? Si un campo, schema, API o formato explícito ya representa la información, quizá no necesitemos que un LLM vuelva a interpretarla.
- ¿Qué parte de la decisión depende de una regla conocida? Si la misma condición debería producir la misma respuesta, puede ser candidata a código determinístico.
- ¿El resultado puede comprobarse objetivamente? Si puede, conviene que esa verificación siga siendo determinística aunque un modelo participe antes.
- ¿La excepción sigue siendo realmente una excepción? Si aparece constantemente y ya comprendemos el patrón, quizá sea momento de consolidarla.
- Si mañana cambio de modelo, qué conocimiento permanece? La respuesta revela cuánto aprendizaje pertenece realmente al sistema.
No son mandamientos. Son un filtro.
A veces la respuesta seguirá siendo «necesito un agente». Perfecto. Ese es exactamente el lugar donde quiero usarlo. Pero otras veces descubriremos que estamos gastando inteligencia en volver a decidir algo que ya entendemos.
Durante un tiempo, la pregunta dominante fue: ¿qué más puedo hacer con agentes?
Todavía me la hago. Pero ahora coloco otra a su lado: ¿qué parte de lo que un agente hace hoy debería dejar de necesitar un agente mañana?
No porque quiera usar menos IA. Porque quiero que cada ciclo deje algo detrás: una regla más clara, una prueba nueva, un contrato más fuerte, una excepción menos ambigua, una capacidad que permanezca cuando la conversación termine.
En resumen, la diferencia no está en usar más o menos IA, sino en saber dónde todavía hace falta interpretar. La IA explora la frontera. Nosotros validamos lo aprendido. El software consolida el territorio. Y entonces la frontera vuelve a moverse.
Así que la próxima vez que pienses «aquí podría poner otro agente», prueba primero con una pregunta más incómoda:
¿Aquí necesito realmente inteligencia… o ya conozco suficientemente bien la respuesta como para convertirla en software?
Referencias
- Comisión Europea, EN 16931 / European standard on eInvoicing: modelo semántico y sintaxis estructuradas para facturas electrónicas. https://ec.europa.eu/digital-building-blocks/sites/spaces/DIGITAL/pages/467108926/Compliance+with+eInvoicing+standard
- OpenAI, A practical guide to building agents: guía sobre cuándo un enfoque con agentes aporta valor y cuándo una solución determinística puede ser suficiente. https://openai.com/business/guides-and-resources/a-practical-guide-to-building-ai-agents/
- Anthropic, Building Effective AI Agents: distinción entre workflows predecibles y agentes para decisiones flexibles dirigidas por el modelo. https://www.anthropic.com/engineering/building-effective-agents
- NIST, Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile (NIST AI 600-1): confabulación, supervisión humana y procesos de prueba, evaluación, validación y verificación. https://doi.org/10.6028/NIST.AI.600-1
- ISO 9001, The process approach in ISO 9001:2015: Plan-Do-Check-Act como ciclo de mejora continua. https://www.iso.org/iso/iso9001_2015_process_approach.pdf