El momento espectacular dura poco: instalas un modelo, escribes un prompt y la respuesta aparece en tu propia máquina. El problema empieza al día siguiente. ¿Puede repetirse el experimento? ¿Sabes qué versión produjo el resultado, cuánto tardó, qué herramienta llamó, qué dato salió de la PC y qué parte falló cuando el flujo dejó de responder?
Ahí cambia la naturaleza del trabajo. Ejecutar un LLM local demuestra que la inferencia funciona; construir un laboratorio local de ingeniería de IA exige convertir esa inferencia en un sistema observable, reproducible y extensible. Esa diferencia fue el punto de partida de mi repositorio público AI Engineering Lab. La ruta práctica comienza con modelos locales y termina conectando agentes, recuperación de información, observabilidad, interfaces, pruebas y un puente MCP hacia un sistema externo. Quizá ya resulte familiar este problema común, pero la diferencia aquí está en tratarlo como ingeniería. Esta es la distinción: el modelo es un componente; el laboratorio es el sistema que permite entenderlo y repetirlo.
La intención no es demostrar que todo debe ejecutarse sin nube. Es más útil mostrar algo menos grandilocuente: la complejidad debe ganarse su lugar. La experiencia del laboratorio funciona como una guía práctica, no como una receta universal.
¿Por qué “local” no significa, por sí solo, “controlado”?
Servir un modelo desde la propia estación de trabajo ya es una pieza útil de infraestructura. Herramientas como LM Studio permiten exponer modelos locales mediante REST y endpoints compatibles con APIs conocidas, lo que facilita probar aplicaciones sin cambiar por completo el código cliente. Ollama cumple un papel similar en varias sesiones del laboratorio.
Sin embargo, “local” no equivale automáticamente a “privado”, “seguro” o “reproducible”. Un agente puede inferir localmente y, al mismo tiempo, consultar la web, invocar una API externa o enviar trazas a un servicio de observabilidad. La ubicación del modelo es solo una parte del sistema. El perfil de IA generativa del NIST AI Risk Management Framework insiste precisamente en gestionar riesgos a lo largo del diseño, desarrollo, uso y evaluación; no basta con escoger dónde corre el modelo.
Para ser claro, ejecutar el modelo en la propia máquina resuelve solo una parte del problema. Por eso el laboratorio se diseñó alrededor de una pregunta distinta: ¿qué tendría que quedar visible para entender el sistema mañana, no solo para verlo funcionar hoy?
¿Qué hace que un laboratorio sea más que una carpeta de demos?
El repositorio conserva una progresión deliberada. Antes de los agentes existe una ruta de modelos open source con LM Studio, Ollama, benchmarks y ejercicios de RAG. Después, cada sesión añade una capacidad y también una nueva superficie de fallo. La regla es sencilla: no incorporar una abstracción antes de saber qué problema resuelve.
1. Primer paso: una línea base que pueda fallar de forma comprensible.
La Session 1 reduce el problema a lo esencial: Ollama, un cliente Python y una API FastAPI con /chat y /health. No hay equipo de agentes, memoria persistente ni búsqueda web. Si la inferencia falla, la distancia entre síntoma y causa todavía es corta.
Esa austeridad es útil. Una línea base estable permite medir latencia, confirmar límites del hardware y separar un problema de infraestructura de un problema de orquestación. El experimento deja de ser “el modelo respondió” y pasa a ser “el servicio responde bajo un contrato conocido”.
2. Segundo paso: herramientas, estado y ejecución controlada.
La Session 2 introduce un runtime de agente con memoria por sesión, herramientas y una interfaz sencilla. Aquí aparece una lección recurrente: un agente útil no es solo un prompt con otro nombre. Necesita estado, reglas para decidir cuándo usar herramientas y una ruta clara para devolver el resultado.
En la Session 3, el mismo entorno añade un flujo multiagente con roles diferenciados. La investigación sobre AutoGen formalizó justamente esta idea: varios agentes configurables pueden colaborar mediante conversación, herramientas e intervención humana en tareas complejas. El valor, sin embargo, depende de la arquitectura de interacción, no del número de agentes. Microsoft Research documentó ese enfoque en AutoGen.
Esa distinción importa porque “más agentes” puede convertirse con facilidad en “más lugares donde algo puede salir mal”. En el laboratorio, los roles permiten observar investigación, análisis, redacción y revisión por separado. No constituyen una afirmación de que cuatro modelos sean intrínsecamente superiores a uno. Si el tema resulta familiar, es la misma pregunta que planteo en ¿Realmente necesitamos otro agente?: la arquitectura debe justificar el costo de coordinación.
¿Cómo se convierte el contexto en memoria útil?
La Session 3.4 añade RAG persistente con Postgres y pgvector, una capa cuantitativa, gráficos y generación de PDF. El cambio conceptual es mayor de lo que parece: parte del conocimiento deja de depender exclusivamente de los parámetros del modelo y pasa a una memoria recuperable que puede inspeccionarse y actualizarse.
La idea de combinar memoria paramétrica con una fuente externa recuperable está en el trabajo original sobre Retrieval-Augmented Generation de Lewis y colaboradores. En este laboratorio, el interés no es reproducir aquel sistema de investigación, sino experimentar con la consecuencia práctica: si el contexto importa, debe existir una ruta verificable para recuperarlo.
También aparecen fallos más interesantes. Por ejemplo, un PDF puede romperse por una URL demasiado larga y un gráfico puede existir en disco sin ser válido para el informe. Un escritor puede repetir secciones ya presentes en el análisis; una consulta RAG puede devolver poco contexto. Documentar esos problemas resulta más valioso que esconderlos, porque muestra dónde termina la demostración y dónde comienza la ingeniería.
¿Por qué la observabilidad importa cuando “funcionó” deja de ser suficiente?
La Session 4 construye un Research Operator sin corpus privado, con búsqueda web, UI y observabilidad. La pregunta ya no es solo qué respuesta produjo el sistema, sino qué ocurrió entre la pregunta y la respuesta: qué nodo tardó, qué fuente se consultó, qué fallback se activó y dónde se perdió un contrato estructurado.
OpenTelemetry resume bien el principio detrás de esta disciplina: sus convenciones semánticas buscan nombres comunes para trazas, métricas y logs, precisamente para que la telemetría pueda correlacionarse entre componentes. El laboratorio usa LangSmith o Langfuse en distintas sesiones, pero la lección es independiente del proveedor: una traza útil debe ayudar a reconstruir el trabajo, no limitarse a confirmar que hubo actividad.
La Session 4 también fuerza una decisión incómoda: el scraping es frágil. Cambios de HTML, bloqueos, CAPTCHA y ruido obligan a definir timeouts, deduplicación, caché y fallbacks. En muchos casos una API estable o un corpus propio resulta mejor base que una cadena de scraping cada vez más sofisticada.
¿Qué se aprende al mantener el mismo problema y cambiar la orquestación?
La Session 5 conserva el objetivo del Research Operator, pero cambia la arquitectura hacia un equipo dinámico estilo AutoGen. Incluye interpretación de consulta, creación de roles, turnos, presupuestos y criterios de finalización. Mantener el objetivo y cambiar la orquestación permite comparar arquitectura, no solamente resultados finales.
La Session 5.1 hace algo todavía más útil: conserva las dificultades. Su variante con CrewAI y contratos JSON estrictos documenta parsing frágil, configuración dispersa, respuestas inconsistentes y capas de abstracción que dificultan el debugging. El ejercicio funciona en varias etapas, pero el propio repositorio señala que ese diseño no quedó recomendado para producción.
Ese registro evita una trampa habitual en los laboratorios de IA: confundir una demo exitosa con una arquitectura ganadora. Una herramienta puede completar la tarea y, aun así, ser una mala elección operativa. Esta limitación también forma parte del historial del laboratorio.
¿Qué ocurre cuando el laboratorio toca un sistema externo?
La Session 6 funciona como cierre porque conecta el pipeline con MetaTrader 5; también añade un servidor MCP, gating determinista, caché y observabilidad. MetaTrader dispone de una integración oficial con Python para obtener datos desde el terminal. En el laboratorio, además, un EA empuja snapshots de mercado hacia el servidor y el pipeline los procesa bajo demanda.
MCP aporta otra pieza: un contrato estandarizado para que aplicaciones con LLM compartan contexto y expongan herramientas. La especificación MCP 2026-07-28 describe hosts, clientes y servidores, además de recursos, prompts y tools. También advierte que esas capacidades abren rutas de acceso a datos y ejecución de código; por eso requieren consentimiento, controles de acceso y cautela con las herramientas.
Ese matiz es esencial. Un puente MCP no convierte un flujo en “agéntico” por arte de magia; lo convierte en integrable. La confiabilidad sigue dependiendo de contratos, validación, permisos, límites y evidencia de ejecución.
Cinco reglas que sobrevivieron a las sesiones: una guía de diseño.
Después de recorrer modelos, RAG, equipos de agentes, trazas y MCP, la conclusión no es que exista un stack perfecto. La clave es conservar evidencia suficiente para decidir qué complejidad aporta valor y cuál solo añade fricción. La siguiente lista funciona como guía de diseño, no como dogma:
- Estabilizar antes de orquestar. Si el endpoint base no es confiable, añadir agentes solo multiplica la incertidumbre.
- Definir contratos antes de añadir autonomía. Entradas, salidas, estados y fallbacks deben ser visibles antes de delegar decisiones al modelo.
- Trazar antes de depurar a ciegas. Latencia, herramientas, errores y resultados intermedios necesitan una historia reconstruible.
- Evaluar con tareas propias. Un benchmark general orienta; una prueba reproducible sobre el trabajo real decide si el sistema sirve.
- Hacer que la complejidad pague renta. RAG, agentes, herramientas o MCP deben eliminar una limitación concreta. Si solo añaden capas, también añaden deuda.
¿Qué ofrece realmente un laboratorio local —y qué no?
Un entorno local puede ofrecer mayor control sobre el runtime, experimentos repetibles y visibilidad de costos computacionales. También permite mantener determinados datos dentro de infraestructura propia, comparar modelos bajo condiciones conocidas y conservar artefactos, configuraciones y pruebas.
No garantiza confidencialidad si el workflow llama servicios externos; tampoco elimina la necesidad de seguridad, evaluación o gobierno. Un modelo local puede alucinar, una herramienta puede fallar y una integración puede exponer más datos de los previstos. El valor del laboratorio está precisamente en hacer esas fronteras visibles.
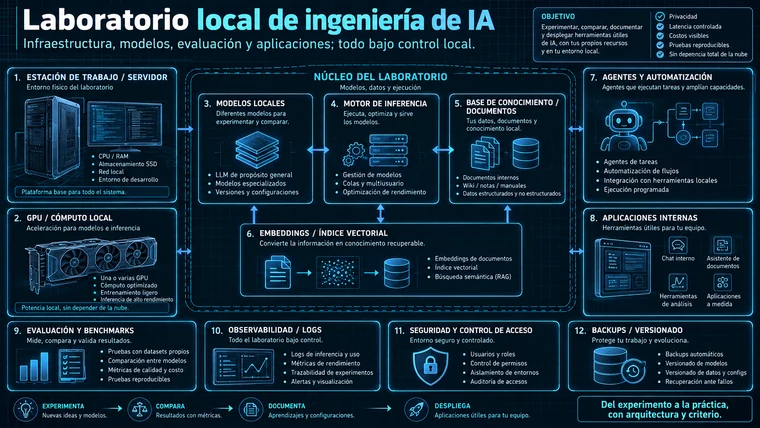
Por eso el blueprint que acompaña este artículo no termina en la GPU. Incluye modelos, motor de inferencia, documentos, índices, agentes, aplicaciones, benchmarks, logs, seguridad y backups. La estación de trabajo es el hardware; el laboratorio es el sistema de evidencia que se construye alrededor.
¿Quieres comprobarlo? No hace falta creerlo.
El repositorio conserva código, roadmaps, READMEs, smoke tests y notas de fallos desde la línea base hasta el Trading Desk. Ese historial puede recorrerse en orden, saltarse a una sesión concreta o utilizarse como referencia para cuestionar una arquitectura propia.
Explora AI Engineering Lab en GitHub. Si una sesión resulta útil, el mejor resultado no es copiar su stack: es poder explicar qué problema resuelve cada capa y qué evidencia demostraría que todavía merece estar allí.