El problema es familiar: si la IA hiciera más rápido a todo desarrollador, en cualquier proyecto, el debate ya estaría resuelto. No lo está. Un experimento controlado de Microsoft Research encontró un resultado llamativo: con GitHub Copilot, una tarea concreta de programación terminó un 55,8 % más rápido. Un ensayo de METR con desarrolladores experimentados encontró lo contrario en repositorios maduros: con herramientas de IA permitidas, el tiempo aumentó un 19 %. En 2026, METR explicó otra limitación: su nueva muestra ya no permitía estimar limpiamente el efecto actual, porque muchos desarrolladores evitaban participar si debían trabajar sin IA.
Ese contraste hace más interesante el caso de DiffDocs. No demuestra que “la IA vuelve a cualquiera diez veces más productivo”. Esta es la distinción útil: cuando dominio, arquitectura, pruebas y decisiones permanecen bajo una responsabilidad clara, la IA puede comprimir trabajo que antes exigía más coordinación, más manos o más calendario.
DiffDocs pasó de una necesidad concreta a un SaaS funcional en 3,5 meses. El registro del proyecto sitúa el desembolso externo incremental alrededor de USD 140 durante ese sprint; esa cifra no equivale al coste económico total, porque no incluye tiempo profesional, hardware ya disponible, electricidad, conectividad ni conocimiento acumulado. Conviene leer ambos datos por separado: uno describe calendario de ejecución; el otro, efectivo externo incremental. Ninguno representa por sí solo el coste total del producto ni un porcentaje universal de ahorro.
El problema no era escribir código
Comparar documentos a mano parece sencillo hasta que el trabajo importa. Dos versiones de un contrato, una especificación técnica, una hoja de cálculo o un informe pueden contener cambios pequeños con consecuencias grandes: una fecha, una cifra, una cláusula eliminada, una fila movida, una condición reescrita.
La revisión manual obliga a mantener dos contextos a la vez: qué cambió y qué significa ese cambio. Es el mismo problema común en contratos, especificaciones y hojas de cálculo; cambia el formato, no la carga cognitiva. Por eso DiffDocs nació alrededor de una idea más concreta que “hacer un diff”: reducir el ruido de la comparación y devolver diferencias que puedan revisarse con contexto. La versión pública actual admite DOCX, PDF, XLSX y CSV, y utiliza una narrativa visual consistente para distinguir contenido añadido, modificado, eliminado y movido.
El producto visible, sin embargo, era solo una parte del trabajo. Detrás de la pantalla hacían falta autenticación, aislamiento entre usuarios y organizaciones, procesamiento asíncrono, colas de trabajo, almacenamiento temporal, créditos, facturación, webhooks, correos transaccionales, seguridad, observabilidad, pruebas y despliegue. Ahí empieza la diferencia entre un script que funciona y un SaaS que puede operar.
Lo que se construyó realmente
El alcance terminó pareciéndose más a un pequeño ecosistema que a una sola aplicación:
- ingesta y comparación documental: DOCX, PDF, XLSX y CSV; extracción, normalización y detección de cambios.
- procesamiento asíncrono: tareas en segundo plano, con colas diferenciadas para cargas normales y pesadas.
- frontend reactivo: carga de archivos, seguimiento de trabajos y resultados renderizados.
- multi-tenancy y acceso: usuarios, organizaciones, permisos y aislamiento de datos.
- billing: créditos, checkout, webhooks y reconciliación.
- seguridad y QA: análisis estático y dinámico, escaneo de secretos, antimalware en uploads, endurecimiento de contenedores, smoke tests y gates de release.
- operación: analítica, SEO, observabilidad y despliegue reproducible.
La arquitectura multi-tenant no es un detalle ornamental. La SaaS Lens de AWS trata el aislamiento, la identidad ligada al tenant, la instrumentación y el onboarding repetible como elementos estructurales. En términos simples: autenticarse correctamente no basta si un tenant pudiera alcanzar datos de otro.
¿Qué significan realmente 3,5 meses?
No significan que cada fase ocurrió de forma perfectamente secuencial. El trabajo se solapó: mientras maduraba el motor de comparación, también cambiaban la interfaz, las colas, el billing y los controles de seguridad. Para efectos de trazabilidad, el proyecto se puede leer en siete bloques:
- Arquitectura base: autenticación, esquema de datos, Docker Compose y estructura de API.
- Motor Diff: parsers, normalización, lógica de comparación y renderizado.
- Frontend: React/Vite, carga de archivos y seguimiento de trabajos.
- Workers y colas: Celery, Redis y separación entre cargas normales y pesadas.
- Billing: integración con Lemon Squeezy, webhooks, créditos y reconciliación.
- Hardening y QA: seguridad, smoke tests, SEO, analítica y gates de release.
- Producción: configuración final, validaciones y go-live.
Separar colas no fue una sofisticación gratuita. Celery documenta el routing de tareas precisamente para enviar tipos de trabajo a colas distintas; en DiffDocs, un XLSX pesado no debía competir de la misma manera que una comparación ligera. Del mismo modo, el billing no terminaba en “mostrar un checkout”: Lemon Squeezy recomienda validar la firma de los webhooks, responder de forma fiable y procesar los eventos con capacidad de recuperación.
¿Qué muestra realmente la comparación económica?
Una comparación económica útil no necesita partir de una cotización de agencia ni de un supuesto “benchmark universal”. Basta construir un escenario explícito, declarar qué roles incluye, durante cuánto tiempo, y separar salario-equivalente, overhead y margen de proveedor del desembolso incremental del proyecto.
Una comprobación sencilla ayuda a dimensionar el orden de magnitud. En mayo de 2025, el Bureau of Labor Statistics de EE. UU. reportó medianas anuales de USD 135.980 para desarrolladores de software y USD 104.300 para analistas y testers de QA. Solo dos desarrolladores más un perfil de QA durante ocho meses representan aproximadamente USD 250.840 en salario-equivalente directo, antes de añadir producto, UX, DevOps, beneficios, overhead, contratación o margen de proveedor.
Ese cálculo no es una cotización para DiffDocs ni representa lo que cualquier agencia cobraría. Sí muestra por qué la comparación económica tiene sentido si se formula con supuestos visibles: el proyecto concentró en una sola dirección técnica funciones que, en otro modelo organizativo, suelen distribuirse entre varios roles.
Y hay una segunda precisión esencial: los ~USD 140 registrados fueron capital externo incremental, no coste total. El tiempo profesional tuvo valor; el hardware tuvo coste; la experiencia previa también. La historia mejora cuando esa distinción se hace explícita, no cuando se oculta.
Lo que cambió no fue solo la velocidad: fue la topología de coordinación
El modelo tradicional tiene ventajas reales: especialización, revisión entre pares, continuidad organizacional y capacidad para trabajar en paralelo. También tiene un coste inevitable de coordinación. Una decisión de producto puede pasar por diseño, backend, frontend, QA y DevOps antes de llegar a producción; cada traspaso introduce contexto que debe explicarse, verificarse y mantenerse alineado.
El flujo usado en DiffDocs redujo muchos de esos traspasos. La arquitectura y los criterios permanecían en una misma cabeza; distintos modelos y herramientas actuaban como ejecutores, revisores o aceleradores de tareas específicas. Esa estructura no elimina la ingeniería: concentra la responsabilidad de ingeniería.
La diferencia importa. Si la especificación es ambigua, un agente puede producir código ambiguo con gran velocidad. Si el modelo de datos está mal, puede propagar el error a más archivos. Si una prueba superficial confirma el comportamiento equivocado, la automatización solo hace que el error llegue antes. La productividad útil aparece cuando el circuito incluye especificación, implementación, validación y evidencia.
El stack de IA evolucionó durante el proyecto
El flujo tampoco nació optimizado. En la primera etapa predominaban Codex dentro del editor, copy-paste y ejecución manual. Después llegaron Skills y MCP; más tarde, CLINE/ROO, indexación de código con embeddings locales y una estrategia multi-modelo para evitar un único cuello de botella.
La lección no está en congelar los nombres de las herramientas —cambian demasiado rápido—, sino en observar qué capacidades modificaron realmente el trabajo:
- contexto de repositorio: entender archivos y relaciones sin reexplicar el proyecto en cada turno.
- herramientas: leer, editar, ejecutar y validar dentro de un flujo controlado.
- especialización: usar modelos distintos cuando la tarea pedía capacidades distintas.
- continuidad: disponer de alternativas cuando aparecían límites de tokens, latencia o disponibilidad.
- auditoría: no aceptar “terminado” como evidencia suficiente.
Los estudios externos ayudan a mantener la interpretación en tierra. El experimento de Microsoft mostró una mejora fuerte en una tarea delimitada; METR encontró el efecto contrario en desarrolladores expertos y repositorios maduros. La IA no aporta una tasa fija de productividad. El efecto interactúa con la tarea, el contexto, la experiencia y el diseño del flujo.
Seguridad desde el principio, pero sin inventar una certificación
El proyecto utilizó internamente la etiqueta “Tier 3” para describir un conjunto avanzado de controles y gates. Para ser claro, existe una limitación importante: esa clasificación es interna; no corresponde a un nivel oficial de NIST, OWASP ni otra entidad certificadora.
Lo importante son los controles verificables. NIST SSDF 1.1 recomienda integrar prácticas seguras dentro del ciclo de desarrollo, no añadirlas al final. OWASP ASVS ofrece una base para verificar controles técnicos de seguridad de aplicaciones. En esa dirección, el proyecto incorporó secret scanning, SAST/DAST, antimalware para archivos, headers de seguridad, endurecimiento de contenedores, SBOM y gates automatizados antes del release.
Algunos controles tienen una razón operacional muy concreta. GitHub Push Protection busca bloquear secretos antes de que entren en el repositorio; la guía 2025 de CISA sobre elementos mínimos de SBOM enfatiza que cada versión o actualización debería mantener un inventario asociado de componentes. Ninguno de esos mecanismos garantiza ausencia de vulnerabilidades; juntos reducen puntos ciegos y generan evidencia para decidir si un release debe avanzar.
Entre “Upload” y “Diff” hay más ingeniería de la que parece
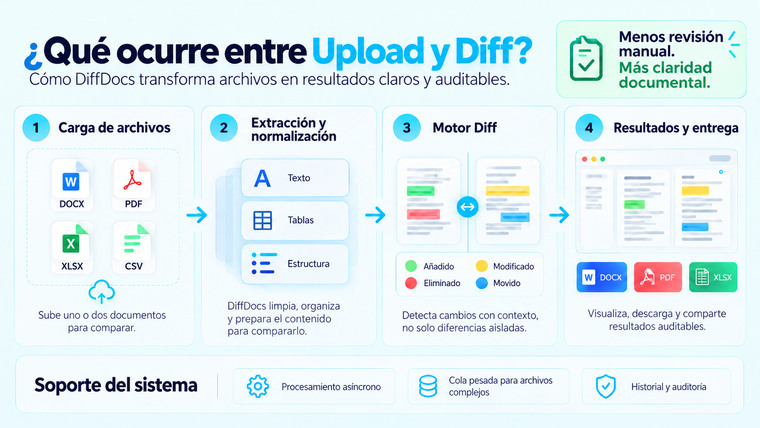
La interfaz puede resumir el proceso en cuatro pasos: carga, extracción y normalización, motor Diff, resultados. Debajo de esa secuencia ocurren decisiones que el usuario no debería tener que administrar: validar tipo y tamaño, escanear archivos, preparar texto, tablas y estructura, encolar cargas pesadas, mantener historial, renderizar diferencias y entregar una salida comprensible.
Ese es también el motivo de los cuatro colores. Verde, amarillo, rojo y azul no pretenden decorar el resultado; convierten tipos de cambio en señales visuales: añadido, modificado, eliminado y movido. El objetivo no es que la máquina “decida por el usuario”, sino que reduzca el coste de encontrar lo que merece revisión.
Lo que la IA sí aceleró —y lo que siguió necesitando dueño
La IA ayudó especialmente donde existían tareas extensas pero verificables: scaffolding, refactors, pruebas, búsqueda dentro del codebase y documentación. También aceleró configuración, exploración de alternativas y ejecución repetitiva; además, permitió cambiar entre implementación y auditoría sin convocar a otro equipo para cada transición.
Pero varias decisiones no podían delegarse sin perder control. Había que definir qué significaba un cambio “movido”, cómo aislar tenants y qué hacer con archivos potencialmente maliciosos; también, cuándo una cola debía ser pesada y qué condiciones bloqueaban un release. Esas decisiones eran arquitectura, producto y riesgo, no simple escritura de código.
Ahí está la tesis que sobrevivió mejor al paso del tiempo: la IA redujo el coste de ejecutar decisiones, pero aumentó la importancia de formularlas bien y verificarlas mejor.
El resultado hoy
DiffDocs dejó de ser un experimento privado y funciona como un producto accesible desde navegador. La página pública permite comparar DOCX, PDF, XLSX y CSV; ofrece créditos de bienvenida, resultados visuales y una política de privacidad por diseño. Puede probarse directamente en DiffDocs.
Eso no convierte una experiencia en receta universal. Un proyecto con regulación estricta, alta disponibilidad contractual, datos extremadamente sensibles o una organización grande puede necesitar más personas, separación de funciones y revisiones independientes. Tampoco significa que un desarrollador deba reemplazar especialización por agentes. Significa que el límite inferior de lo que una persona técnicamente responsable puede construir se movió.
Cinco lecciones que valieron más que cualquier modelo concreto
1. El contexto vale tanto como el modelo. Un agente brillante que desconoce el repositorio vuelve a preguntar, duplica lógica y pierde decisiones anteriores.
2. La velocidad sin gates no es productividad. Un cambio solo cuenta cuando compila, pasa pruebas, respeta seguridad y mantiene el contrato del producto.
3. Las herramientas cambian; los contratos sobreviven. Editor, modelo y proveedor pueden rotar. Especificaciones, tests, observabilidad y criterios de aceptación deben permanecer.
4. Un backup de proveedor es continuidad operativa, no colección de modelos. La redundancia solo sirve si el trabajo puede migrar sin reconstruir todo el contexto.
5. La arquitectura humana sigue siendo el cuello de botella correcto. Cuando el coste de producir código baja, aumentan el valor de decidir qué construir, cómo comprobarlo y cuándo no desplegar.
Conclusión
DiffDocs no demuestra que seis personas sean innecesarias, ni que USD 140 sustituyan el valor de meses de trabajo profesional. Demuestra otra cosa: una combinación de experiencia de dominio, arquitectura explícita, agentes de IA, automatización y gates verificables puede concentrar una cantidad de trabajo que antes habría requerido una estructura mucho mayor.
La pregunta interesante ya no es “¿puede la IA escribir el código?”. Puede escribir mucho. La pregunta que decide si aparece un producto o una pila de archivos es más exigente. ¿Quién conserva el modelo mental, los criterios y la responsabilidad cuando el código se vuelve barato de producir? DiffDocs fue una respuesta práctica a esa pregunta. El resultado puede verse y probarse; la arquitectura, las limitaciones y las lecciones son más útiles que cualquier titular de ahorro.